deepseek v4.1 flash
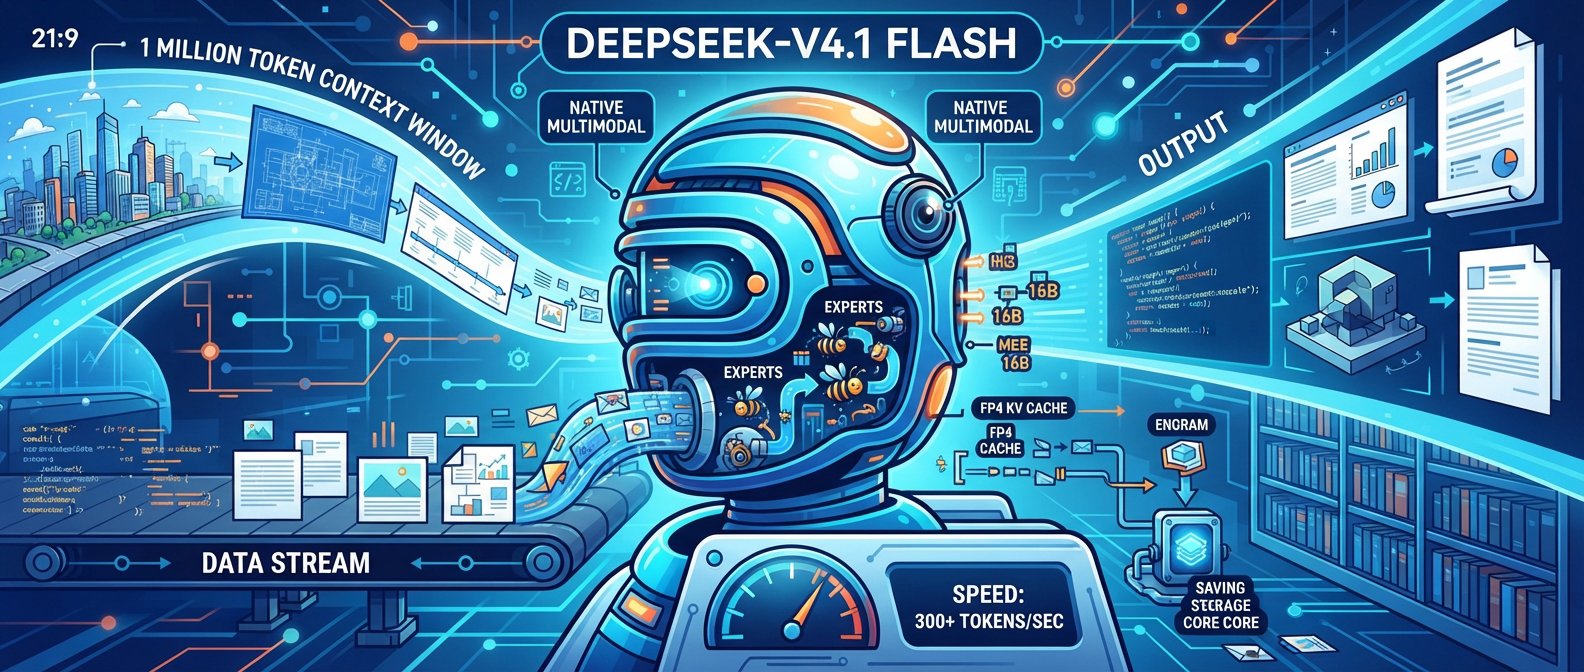
Neuartige Architektur (CED):
Das Modell basiert auf der von DeepSeek eingeführten Causal Encoder-Decoder (CED)-Architektur (ein 40-Schichten-Transformer, aufgeteilt in 20 Encoder- und 20 Decoder-Layer). Bei einer Backbone-Größe von 552 Milliarden Parametern arbeitet es extrem sparsam und aktiviert pro Token nur etwa 8 Milliarden Parameter beim Input (Prefill) und 16 Milliarden beim Output (Decode).
Native Multimodalität:
Im Gegensatz zu älteren Zwischenversionen besitzt V4.1-Flash eine von Beginn an integrierte, native Bild- und Textverarbeitung. Dadurch können visuelle Eingaben (wie Screenshots, UI-Zustände oder technische Diagramme) nahtlos in Agenten-Workflows einfließen.
Riesiger Kontext & Output:
Es unterstützt ein Kontextfenster von bis zu 1 Million Token sowie eine maximale Ausgabelänge von bis zu 384.000 Token.
Revolutionäres KV-Cache-Management:
Durch Techniken wie Compressed Sparse Attention 2 (CSA2) und FP4-Quantisierung (Speicherung des Haupt-KV-Caches in 4-Bit-Präzision) wurde der Speicherbedarf im Grafikspeicher (HBM) auf etwa 890 Bytes pro Token gesenkt – rund ein Viertel des Vorgängers. Ergänzt wird dies durch ein „Engram“-Speichermodul (196 Milliarden Parameter), das Hintergrundwissen über Token-Lookups effizient verwaltet.
Fokus auf Coding- und Terminal-Agenten:
Das Modell ist primär für automatisierte Programmieraufgaben, Multi-Step-Prozesse und lange Tool-Call-Sequenzen optimiert.
Geschwindigkeit & Wirtschaftlichkeit:
Dank hoher Inferenzgeschwindigkeiten (oft über 300 bis 400 Token pro Sekunde in optimierten Umgebungen) und sehr niedrigen API-Preisen ist es eines der stärksten Value-Modelle für High-Volume-Anwendungen. DeepSeek setzt es intern sogar so effizient ein, dass es ältere Pro-Modelle in vielen Bereichen ablöst.